Google Research prezentuje Retrieve-for-Train (R4T) – dyfuzyjny retriever 20 razy szybszy
Google Research wprowadziło Retrieve-for-Train (R4T), nowatorski framework wyszukiwania, który generuje spójne i zróżnicowane zestawy wyników. Wykorzystuje on model językowy trenowany wzmocnieniem do syntezy danych treni
Google Research przedstawiło Retrieve-for-Train (R4T), innowacyjny framework wyszukiwania, który ma za zadanie dostarczać spójne i zróżnicowane zestawy wyników. Kluczową cechą R4T jest jego zdolność do generowania wszystkich kierunków wyszukiwania w jednym przebiegu, co przekłada się na znacznie większą prędkość działania w porównaniu do tradycyjnych metod.
Architektura i działanie R4T
Framework R4T opiera się na dwuetapowym procesie. W pierwszej fazie, model językowy typu fan-out jest trenowany jednorazowo przy użyciu uczenia ze wzmocnieniem (RL). Proces ten uwzględnia nagrody za ugruntowanie, różnorodność i spójność, co pozwala na optymalizację modelu pod kątem generowania wysokiej jakości danych. Po zakończeniu treningu, ten model językowy jest wykorzystywany do syntezy danych treningowych.
Te syntetyczne dane są następnie używane do szkolenia dyfuzyjnego retrivera o parametrach wynoszących 53,9 miliona. To właśnie ten retriever odpowiada za finalne wyszukiwanie. Dzięki swojej architekturze, jest on w stanie wygenerować wszystkie potrzebne kierunki wyszukiwania podczas jednego przejścia, co znacząco przyspiesza cały proces.
Znacząca poprawa wydajności
Jedną z najbardziej imponujących cech R4T jest jego wydajność. Według Google Research, dyfuzyjny retriever działa od 12 do 20 razy szybciej niż autoregresywne metody fan-out. Ta znacząca poprawa prędkości może mieć istotne konsekwencje dla systemów wyszukiwania, umożliwiając szybsze i bardziej efektywne dostarczanie wyników.
Należy jednak zaznaczyć, że na chwilę obecną nie udostępniono kodu ani wag modelu R4T. Oznacza to, że technologia jest wciąż na etapie badawczym i nie jest jeszcze dostępna dla szerszej publiczności czy deweloperów.
Prezentacja R4T przez Google Research wskazuje na dalsze dążenie do optymalizacji i przyspieszania procesów wyszukiwania w erze sztucznej inteligencji. Rozwiązania takie jak dyfuzyjny retriever, zdolne do wielokrotnego zwiększenia prędkości działania, mogą w przyszłości zrewolucjonizować sposób, w jaki systemy AI przetwarzają i dostarczają informacje, otwierając nowe możliwości dla bardziej dynamicznych i responsywnych aplikacji.
Źródło: marktechpost.com
Komentarze
Zaloguj się, aby dołączyć do dyskusji.
Nikt jeszcze nie skomentował. Bądź pierwszy!
Czytaj dalej
Google DeepMind powołuje interdyscyplinarny instytut do badania AGI
Google DeepMind utworzyło DeepMind Institute (DMI), aby interdyscyplinarnie badać sztuczną ogólną inteligencję (AGI), koncentrując się na bezpieczeństwie, zarządzaniu i ryzykach. Instytut ma łączyć perspektywy technologi
Redakcja Aigest21 godz. temu
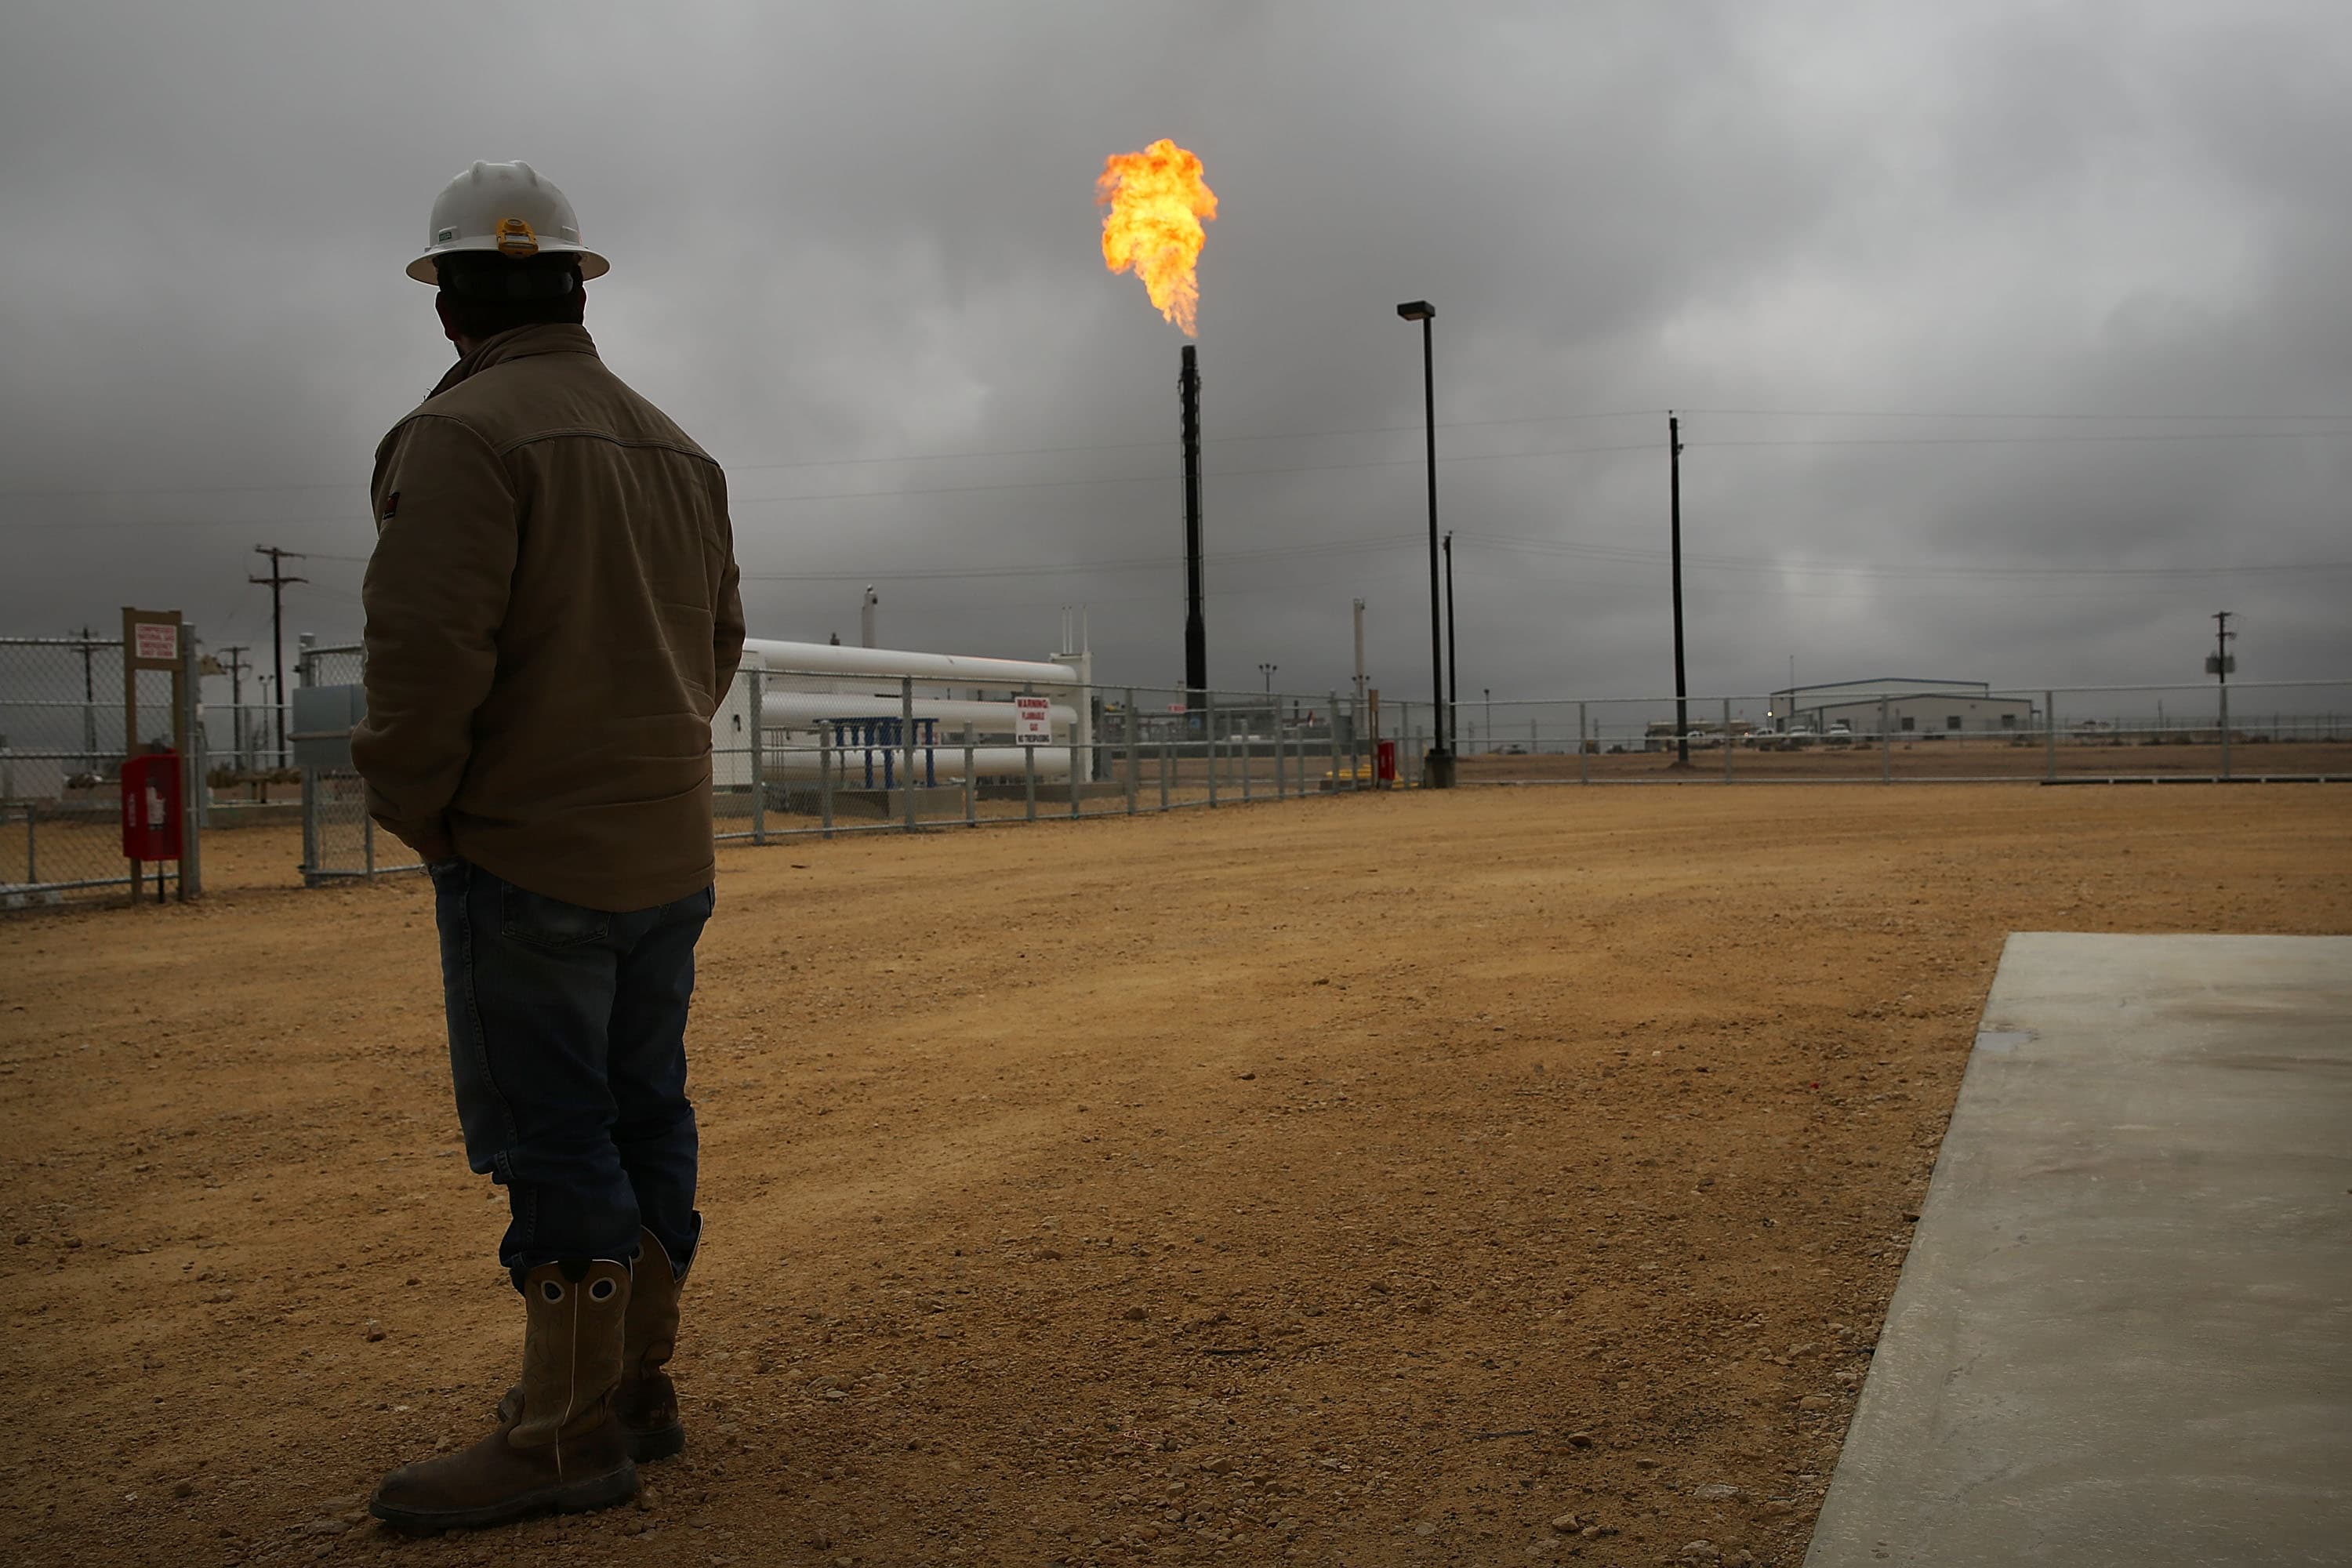
Centra danych w USA mogą zużyć więcej gazu niż Niemcy i Japonia razem wzięte do 2035 roku
Wzrost zapotrzebowania na sztuczną inteligencję może doprowadzić do drastycznego wzrostu zużycia gazu ziemnego przez amerykańskie centra danych, przewyższając łączne zużycie Niemiec i Japonii.
Redakcja Aigestwczoraj
Czy zaawansowana sztuczna inteligencja może zagrozić ludzkości? Debata MIT Technology Review
MIT Technology Review zorganizowało debatę na temat obaw związanych z potencjalnym zagrożeniem egzystencjalnym ze strony zaawansowanej sztucznej inteligencji.
Redakcja Aigestwczoraj
iOS 27: Siri odzyskuje blask dzięki integracji z Google Gemini i nowym funkcjom
Najnowsza aktualizacja systemu iOS 27 znacząco odmienia asystenta Siri, czyniąc go bardziej użytecznym i kontekstowym. Użytkownicy zauważają, że po latach marginalnego wykorzystania, Siri staje się kluczowym narzędziem d
Redakcja Aigest2 dni temu
Badacz z Princeton proponuje Recurrent Looped Transformer (RLT) z nieskończoną głębią czasową
Yifan Zhang z Princeton zaprezentował koncepcję Recurrent Looped Transformer (RLT), innowacyjnego modelu łączącego koder przyczynowy z rekurencyjnym dekoderem. Rozwiązanie to ma na celu usprawnienie przetwarzania sekwenc
Redakcja Aigest3 dni temu
Przyspieszanie procesów uczenia maszynowego z NVIDIA cuML i RAPIDS
Praktyczny poradnik prezentuje, jak budować i przyspieszać procesy uczenia maszynowego, wykorzystując narzędzia NVIDIA cuML i RAPIDS, skupiając się na optymalizacji wydajności i interpretowalności modeli.
Redakcja Aigest4 dni temu
Bądź na bieżąco ze światem AI
Najważniejsze newsy, recenzje i poradniki — raz w tygodniu, prosto na maila. Bez spamu.