NVIDIA NeMo AutoModel przyspiesza dostrajanie modeli Transformerów
NVIDIA wprowadza NeMo AutoModel, narzędzie do automatyzacji i optymalizacji procesu dostrajania dużych modeli językowych (LLM) opartych na architekturze Transformer, znacząco skracając czas i koszty.
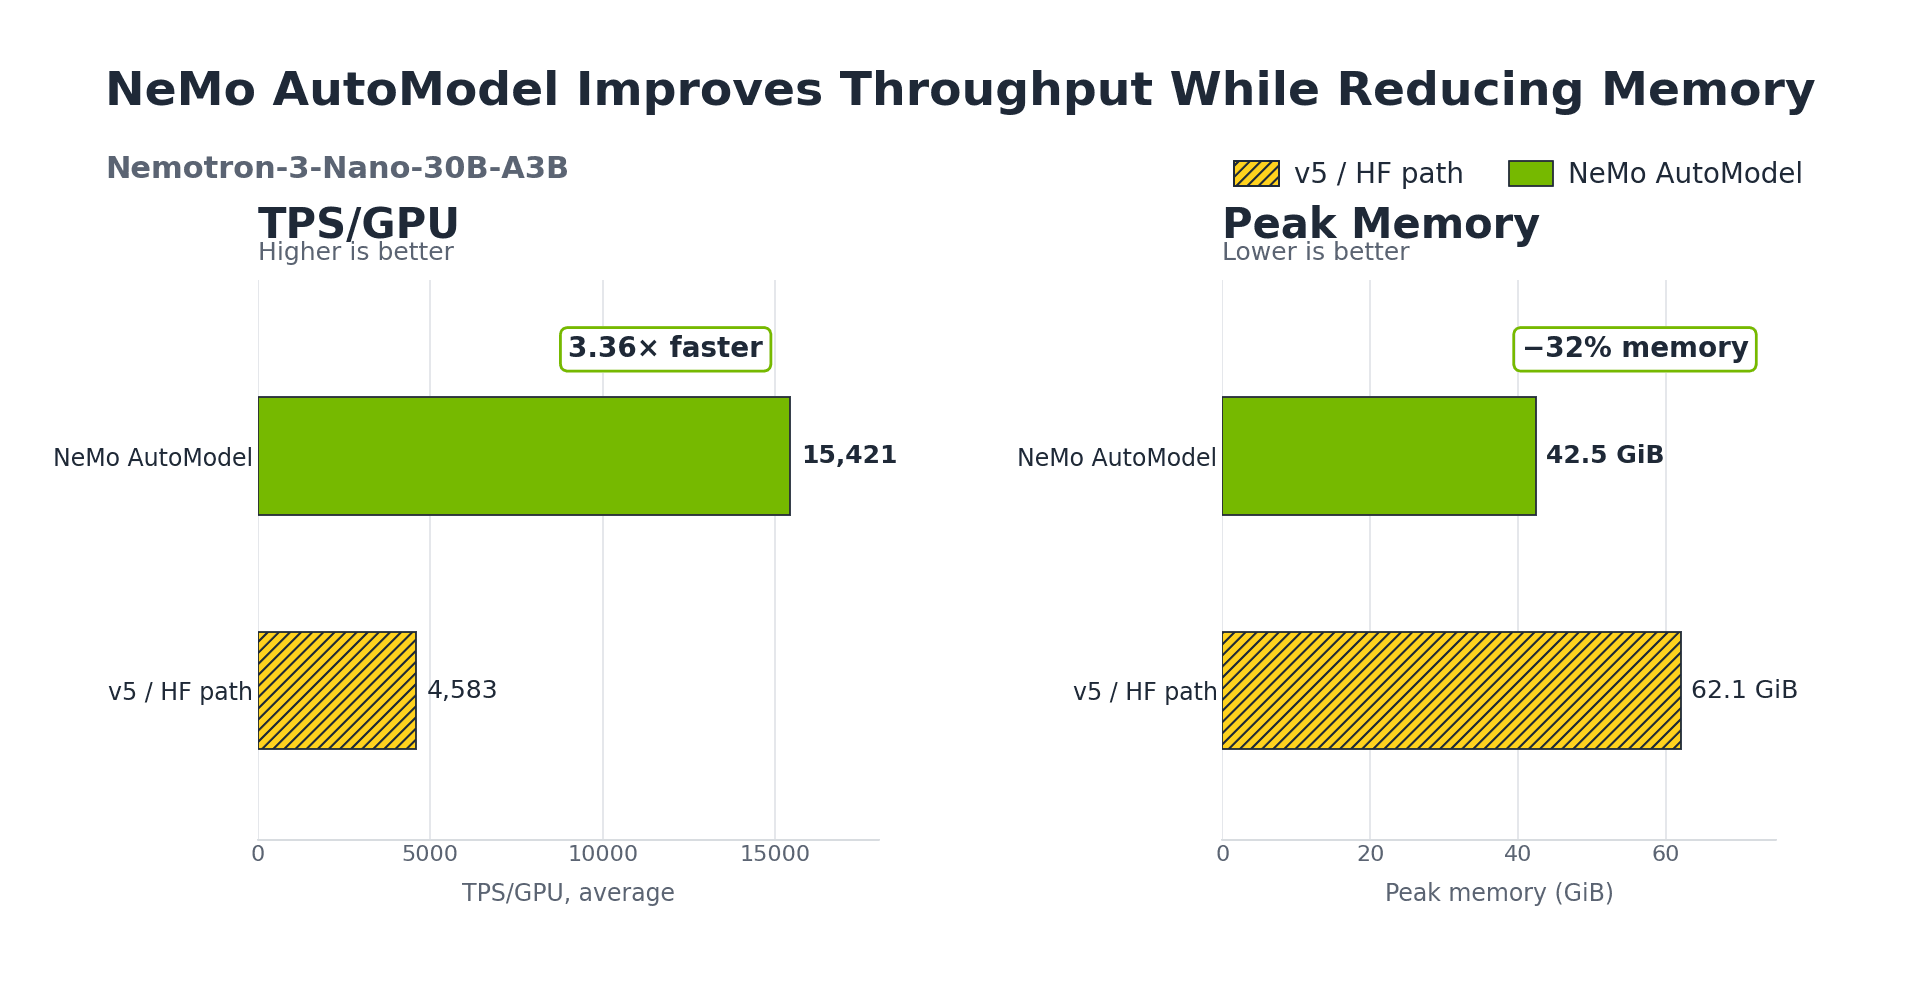
NVIDIA zaprezentowała NeMo AutoModel, innowacyjne narzędzie zaprojektowane w celu radykalnego przyspieszenia i uproszczenia procesu dostrajania dużych modeli językowych (LLM) opartych na architekturze Transformer. Rozwiązanie to ma na celu zredukowanie czasu, kosztów oraz złożoności związanej z optymalizacją modeli, umożliwiając programistom i badaczom efektywniejsze wykorzystanie zaawansowanych algorytmów AI.
Automatyzacja i optymalizacja dostrajania
NeMo AutoModel koncentruje się na automatyzacji kluczowych etapów procesu dostrajania, które tradycyjnie wymagały znacznego nakładu pracy ręcznej i eksperckiej wiedzy. Narzędzie to automatycznie dobiera optymalne hiperparametry, takie jak szybkość uczenia, rozmiar partii (batch size) czy harmonogram szybkości uczenia, co jest kluczowe dla osiągnięcia wysokiej wydajności modelu. Ponadto, NeMo AutoModel samodzielnie wybiera najbardziej efektywne strategie uczenia, eliminując potrzebę ręcznego testowania wielu konfiguracji.
Jedną z głównych zalet jest możliwość automatycznego wyboru najlepszego modelu spośród wielu eksperymentów. Po zakończeniu procesu dostrajania, narzędzie identyfikuje model, który osiągnął najlepsze wyniki na podstawie zdefiniowanych metryk, co znacznie skraca czas potrzebny na selekcję i walidację. Dodatkowo, NeMo AutoModel oferuje funkcję wczesnego zatrzymywania (early stopping), która przerywa proces uczenia, gdy model przestaje się poprawiać, zapobiegając nadmiernemu dopasowaniu (overfitting) i oszczędzając zasoby obliczeniowe.
Integracja i dostępność
NVIDIA NeMo AutoModel jest częścią szerszego ekosystemu NVIDIA NeMo, który obejmuje kompleksowe narzędzia do budowania, dostrajania i wdrażania modeli językowych. Narzędzie jest dostępne jako otwarte oprogramowanie (open-source) na platformie Hugging Face, co ułatwia jego integrację z istniejącymi przepływami pracy i promuje współpracę w społeczności AI. Dostępność na tej popularnej platformie zapewnia szeroki zasięg i możliwość wykorzystania przez deweloperów na całym świecie.
Korzyści z zastosowania NeMo AutoModel
Zastosowanie NeMo AutoModel przynosi szereg wymiernych korzyści. Przede wszystkim, znacząco skraca czas potrzebny na dostrojenie modeli, co przekłada się na szybsze iteracje i krótszy cykl rozwoju produktów opartych na AI. Redukcja kosztów obliczeniowych jest kolejną istotną zaletą, wynikającą z efektywniejszego wykorzystania zasobów i automatycznego wczesnego zatrzymywania. Upraszcza to również proces dla użytkowników, którzy nie posiadają głębokiej wiedzy eksperckiej w zakresie optymalizacji modeli, demokratyzując dostęp do zaawansowanych technik dostrajania.
Wprowadzenie NVIDIA NeMo AutoModel stanowi istotny krok w kierunku demokratyzacji i przyspieszenia rozwoju aplikacji opartych na dużych modelach językowych. Upraszczając i automatyzując złożone procesy dostrajania, NVIDIA umożliwia szerszemu gronu deweloperów i firm efektywne wykorzystanie potencjału AI, co może przyczynić się do powstania nowych, innowacyjnych rozwiązań w wielu branżach.
Źródło: huggingface.co
Komentarze
Zaloguj się, aby dołączyć do dyskusji.
Nikt jeszcze nie skomentował. Bądź pierwszy!
Czytaj dalej
Nokia udostępnia AnyJev: narzędzie do przekształcania otwartych LLM w modele decyzyjne bez treningu
Zespół badawczy Nokii udostępnił AnyJev, bibliotekę Pythona, która pozwala otwartym dużym modelom językowym (LLM) działać jako modele decyzyjne, nie wymagając przy tym dodatkowego treningu.
Redakcja Aigest10 godz. temu
NVIDIA prezentuje SoL-Pi: pętle auto-badawcze redukujące ruch tokenów agenta kodującego nawet o 49%
Badacze z NVIDII wprowadzili SoL-Pi, zestaw mechanizmów dla agenta kodującego Pi, które znacząco obniżają zużycie tokenów i koszty API, zachowując wysoką wydajność.
Redakcja Aigestwczoraj
Transformers integruje kwantyzację llama.cpp, przyspieszając wnioskowanie LLM
Hugging Face ogłosiło integrację kwantyzacji llama.cpp z biblioteką Transformers, co znacząco przyspiesza wnioskowanie dużych modeli językowych (LLM) na procesorach CPU. Umożliwia to efektywne uruchamianie skwantyzowanyc
Redakcja Aigestwczoraj
Apple planuje serwer AI z układami M-series Ultra i rozważa współpracę z Nvidią
Apple pracuje nad serwerem AI wykorzystującym układy M-series Ultra, z planowaną premierą na rok 2029. Projekt, wspierany przez nowego CEO Johna Ternusa, może oznaczać powrót firmy na rynek serwerów korporacyjnych po nie
Redakcja Aigest6 dni temu
NVIDIA udostępnia OSMO: jeden plik YAML do orkiestracji AI w robotyce
NVIDIA udostępniła OSMO, narzędzie do orkiestracji przepływów pracy oparte na Kubernetesie, które umożliwia definiowanie zadań AI dla robotyki w jednym pliku YAML.
Redakcja Aigest14 wrz 2026
Badacz z Princeton proponuje Recurrent Looped Transformer (RLT) z nieskończoną głębią czasową
Yifan Zhang z Princeton zaprezentował koncepcję Recurrent Looped Transformer (RLT), innowacyjnego modelu łączącego koder przyczynowy z rekurencyjnym dekoderem. Rozwiązanie to ma na celu usprawnienie przetwarzania sekwenc
Redakcja Aigest13 wrz 2026
Bądź na bieżąco ze światem AI
Najważniejsze newsy, recenzje i poradniki — raz w tygodniu, prosto na maila. Bez spamu.